Yuu Jinnai
Home
Google Scholar
GitHub
Current Research:
Language Model Finetuning
Minimum Bayes Risk Decoding
Language Model Alignment
Prior Projects:
Parallel Best-First Search
Automated Skill Discovery
日本語:
Japanese
Open Data Structures
ヒューリスティック探索入門
Hosted on GitHub Pages — Theme by orderedlist
Language Model Finetuning
Language model finetuning and post-training specialize pre-trained foundation models into efficient, robust, and capable models for target tasks. My work focuses on developing compact domain-specialized models, reasoning-oriented models for non-English languages, and effective alignment and preference optimization methods.
All open-source models and datasets are available on Hugging Face (@cyberagent).
Developed Models
Reasoning Models (RLMs)
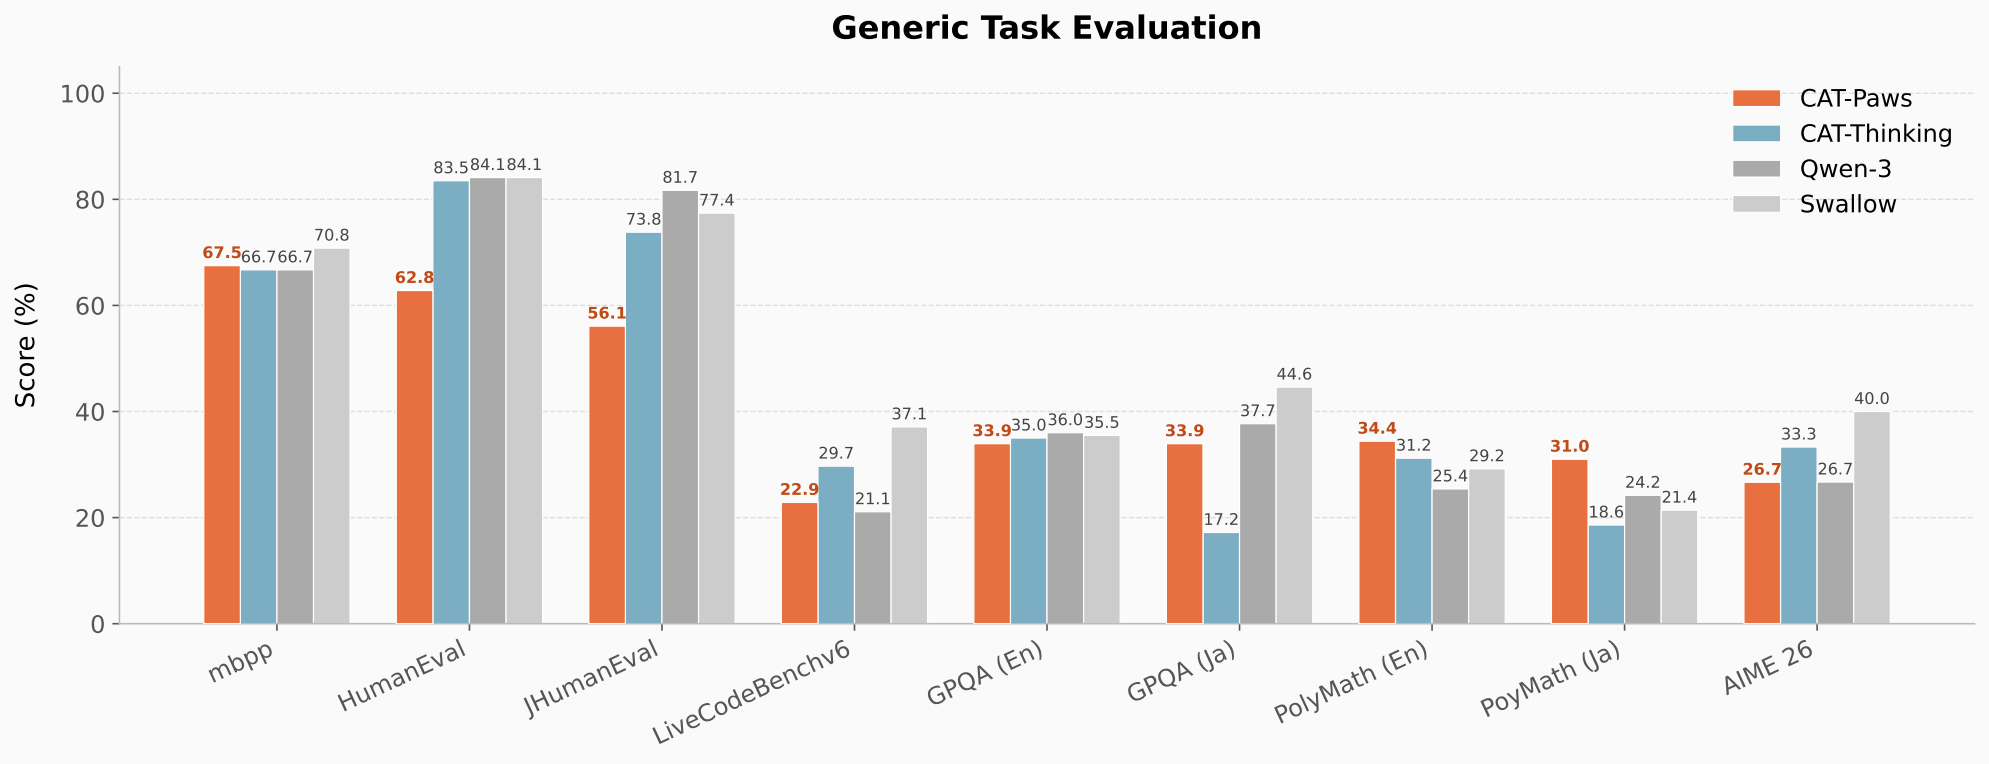
| Model | Base Architecture | Description | Links |
|---|---|---|---|
| CAT-Thinking-8B | Qwen3-8B | Japanese reasoning model producing explicit Japanese thinking traces. Addresses the performance disparity and “reasoning tax” when solving non-English reasoning tasks. | MODEL | PAPER | DATASET |
| CAT-Paws-8B | Qwen3-8B | Sibling reasoning model of CAT-Thinking-8B specially tuned for agentic, multi-turn, and tool-use environments. | MODEL | PAPER | DATASET |
Compact Machine Translation (CAT-Translate Series)
The CAT-Translate series demonstrates that compact, bilingual-specialized language models can match or outperform large multilingual models while providing significantly lower inference latency and memory requirements.
| Model | Parameters | Base Model | Links |
|---|---|---|---|
| CAT-Translate-7b | 7B | Mistral | MODEL | PAPER | DATASET |
| CAT-Translate-3.3b | 3.3B | Llama-3.2 | MODEL | PAPER | DATASET |
| CAT-Translate-1.4b | 1.4B | Qwen2.5 | MODEL | PAPER | DATASET |
| CAT-Translate-0.8b | 0.8B | Qwen2.5 | MODEL | PAPER | DATASET |
Preference Optimization & Self-Improvement
| Model | Base Architecture | Description | Links |
|---|---|---|---|
| calm3-22b-chat-selfimprove-experimental | calm3-22b-chat | Self-improvement conversational model leveraging calm3-22b-chat for data augmentation and self-training. | MODEL |
| calm2-7b-chat-dpo-experimental | calm2-7b | Conversational Japanese LLM aligned with Direct Preference Optimization (DPO). Investigates cross-cultural alignment and commonsense morality. | MODEL | PAPER | DATASET |
Datasets and Benchmarks
We have developed and released multiple public datasets and evaluation benchmarks on Hugging Face:
- JOR-Bench: Japanese Operations Research Benchmarks for Large Language Models. A collection of five benchmarks (translated and verified into Japanese) for evaluating LLMs on complex mathematical modeling and operations research problems. (In Findings of the Association for Computational Linguistics (EACL-27 Findings), Paper)
- CAT-Thinking-Dataset: High-quality Japanese chain-of-thought and reasoning traces for training reasoning models. (Paper)
- CAT-Translate-Dataset: Parallel translation dataset for training compact Japanese-English translation models. (Paper)
- YokaiEval: Evaluation benchmark assessing LLMs’ understanding of culturally specific Japanese folklore entities (Yokai). (Paper)
- chatbot-arena-ja-calm2-7b-chat-experimental: Japanese pairwise preference data for alignment and DPO fine-tuning. (Paper)
Associated Publications
- Jinnai Y. 2027. JOR-Bench: Japanese Operations Research Benchmarks for Large Language Models. In Findings of the Association for Computational Linguistics (EACL-27 Findings).
PAPER | DATASET - Jinnai Y. 2026. Cost of Reasoning in non-English Languages: A Case Study on Japanese. arXiv preprint arXiv:2607.10114.
PAPER | MODEL (Thinking) | MODEL (Paws) | DATASET - Jinnai Y. 2026. CAT-Translate: Building Compact Open-Source Models for Japanese-English Translation. arXiv preprint arXiv:2606.21413.
PAPER | MODELS | DATASET - Ichihara Y, Jinnai Y, Ariu K, Uchibe E. 2026. Consensus Group Relative Policy Optimization for Text Generation. Proceedings of the 2026 Conference on Empirical Methods in Natural Language Processing (EMNLP-26 Main).
PAPER | CODE - Ichihara Y, Jinnai Y, Morimura T, Sakamoto M, Mitsuhashi R, Uchibe E. 2026. MO-GRPO: Mitigating Reward Hacking of Group Relative Policy Optimization on Multi-Objective Problems. Transactions of the Association for Computational Linguistics (TACL 2026).
PAPER | CODE - Ichihara Y, Jinnai Y. 2025. Auto-Weighted Group Relative Preference Optimization for Multi-Objective Text Generation Tasks. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track (EMNLP-25 Industry).
PAPER | CODE - Jinnai Y, Honda U. 2025. Annotation-Efficient Preference Optimization for Language Model Alignment. Findings of the Association for Computational Linguistics (EMNLP-25 Findings).
PAPER | CODE - Jinnai Y. 2024. Does Cross-Cultural Alignment Change the Commonsense Morality of Language Models? Proceedings of the 2nd Workshop on Cross-Cultural Considerations in NLP (C3NLP Workshop at ACL 2024). 🏆 Best Paper Award
PAPER | MODEL | DATASET